
Comment permettre à une intelligence artificielle de comprendre le sens profond de vos documents plutôt que de simples mots-clés ? Les bases de données vectorielles transforment vos textes, images et sons en tableaux de nombres flottants, appelés embeddings, pour organiser l’information dans un espace multidimensionnel où la proximité mathématique reflète la similarité sémantique.
Pourtant, les systèmes SQL traditionnels échouent dès que le contexte devient flou ou que les données ne sont plus structurées. Pour surmonter ces limites, nous allons examiner ensemble ce qu’est une base de données vectorielle c’est quoi et comment elle optimise vos architectures de génération augmentée par récupération.
- Comprendre la base de données vectorielle et son rôle
- Distinction entre modèles relationnels et systèmes vectoriels
- Comment fonctionnent la similarité et l’indexation ?
- Architecture RAG pour la performance des LLM
- 3 critères pour choisir et maintenir vos index
Comprendre la base de données vectorielle et son rôle
Les bases de données vectorielles indexent des embeddings, représentations numériques capturant le sens sémantique. Elles propulsent les architectures RAG en permettant une recherche par similarité cosinus, dépassant les limites strictes du SQL traditionnel.
Tableaux de nombres flottants représentant des données non structurées et capturant leur signification profonde.
Comprendre les bases de données vectorielles pour l’IA générative demande d’appréhender la conversion du sens en mathématiques pures.
Le concept d’embeddings comme langage universel de l’IA
L’embedding transforme un mot ou une image en chiffres. Ces nombres situent l’information dans un espace multidimensionnel précis. C’est une traduction mathématique du réel.
Le positionnement mathématique traduit la proximité de sens. Plus les vecteurs sont proches, plus les idées sont liées. L’espace vectoriel devient un dictionnaire géométrique géant.
Pensez à bien réussir votre cahier des charges pour un projet ia. Une structure claire évite les dérives techniques.
Transformation des données non structurées en coordonnées numériques
La vectorisation traite le son comme les pixels. Chaque média est décomposé en caractéristiques clés extraites par des modèles. Le résultat reste un tableau numérique.
Les machines manipulent ces coordonnées pour comparer des fichiers sans métadonnées. C’est une avancée majeure pour traiter le vrac. Le stockage devient purement mathématique.
- Texte brut
- Fichiers audio
- Images satellites
- Signaux capteurs IoT
Distinction entre modèles relationnels et systèmes vectoriels
Mais pourquoi ne pas simplement utiliser nos bonnes vieilles tables SQL pour ces nouvelles tâches ? En fait, la structure rigide des bases classiques se heurte à un mur dès que le contexte devient flou.
Limites des requêtes SQL face à la recherche sémantique
Le SQL repose sur des correspondances exactes de caractères. Si vous cherchez « auto », vous raterez le mot « voiture ». Cette approche binaire ignore totalement l’intention réelle de votre utilisateur.
Les bases classiques échouent à gérer les nuances du langage humain. Elles ne comprennent pas les synonymes ou les concepts proches sans règles explicites. Le coût de maintenance devient vite prohibitif. La recherche sémantique demande une souplesse que les index B-Tree ne possèdent pas.
La recherche par mots-clés est une prison syntaxique là où le vecteur offre une liberté conceptuelle totale pour l’intelligence artificielle.
Correspondances exactes, logique binaire, schéma rigide et structuré.
Similarité sémantique, compréhension du contexte, gestion des médias non structurés.
Flexibilité du stockage pour les formats multimédias complexes
Les index vectoriels acceptent des formats disparates sans schéma prédéfini. Vous stockez des représentations de connaissances plutôt que des colonnes figées. Cette agilité est vitale pour les projets d’IA.
Le choix technique s’impose pour toute application moderne utilisant des LLM. La performance en lecture sur des données non structurées est incomparable. C’est le socle de l’innovation logicielle actuelle.
Comprendre les bases de données vectorielles pour l’IA générative demande d’identifier le bon partenaire technique. Pensez à choisir votre prestataire ia pour un projet métier pour illustrer l’importance du conseil technique.
Comment fonctionnent la similarité et l’indexation ?
Une fois les données stockées sous forme de points, comment la machine parvient-elle à retrouver les plus pertinents en un éclair ? Tout repose sur une géométrie de haute précision et des algorithmes de navigation astucieux.
Calcul des distances euclidiennes et similarité cosinus
La distance euclidienne mesure l’écart direct entre deux points. La similarité cosinus, elle, observe l’angle entre les vecteurs. Ces outils mathématiques identifient les contenus les plus proches.
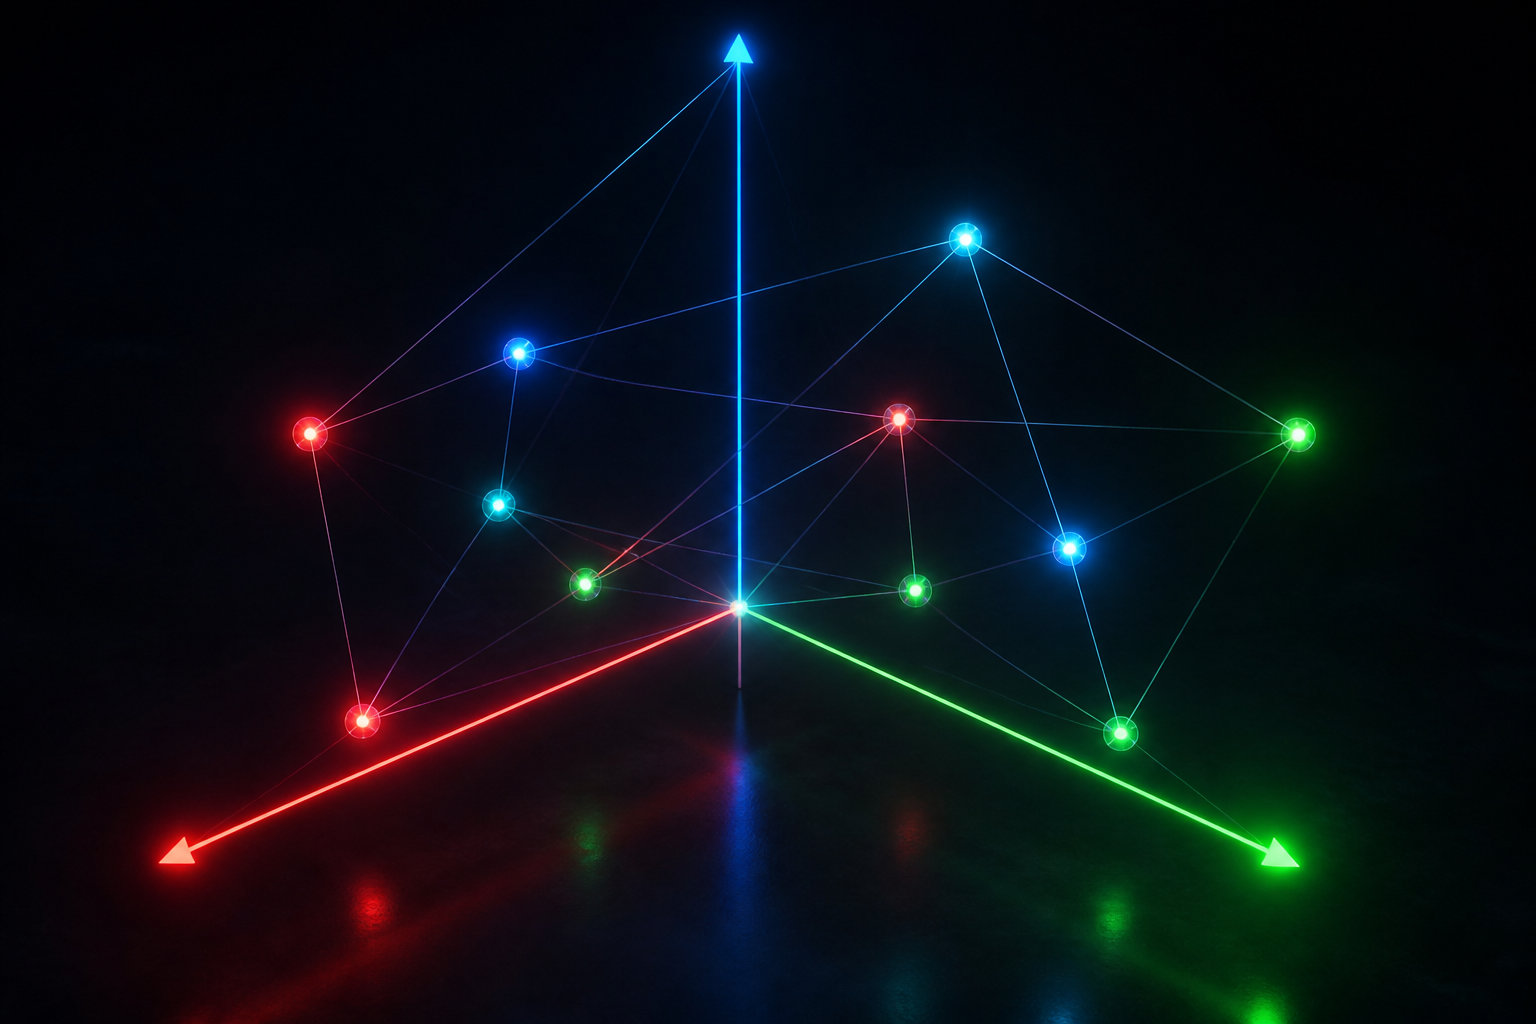
Le produit scalaire permet de classer les résultats par pertinence décroissante. C’est ainsi que l’IA sait quel document répond le mieux à votre question. La précision dépend directement de la qualité de ces calculs. La métrique de distance est le juge de paix de la recherche.
| Métrique | Usage principal | Avantage clé |
|---|---|---|
| Distance Euclidienne | Clustering et données spatiales. | Mesure la distance spatiale réelle. |
| Similarité Cosinus | Recherche sémantique de texte. | Indépendante de la taille du texte. |
| Produit Scalaire | Systèmes de recommandation. | Très rapide sur vecteurs normalisés. |
Algorithmes HNSW et IVF pour la célérité des traitements
HNSW crée des graphes hiérarchiques pour naviguer rapidement dans les données. IVF découpe l’espace en clusters pour limiter le périmètre de recherche. Ces structures garantissent une latence minimale.
La recherche des voisins approximatifs (ANN) sacrifie une infime précision pour un gain de vitesse colossal. Sur des millions de vecteurs, c’est la seule approche viable techniquement. La performance brute en dépend totalement. L’indexation avancée évite l’engorgement des serveurs lors des pics de requêtes.
Comprendre les bases de données vectorielles pour l’IA générative nécessite une infrastructure robuste comme le développement application IA pour le secteur industriel.
Gestion de la dimensionnalité pour préserver la précision
Plus un vecteur a de dimensions, plus les calculs s’alourdissent. C’est ce qu’on appelle la malédiction de la dimensionnalité. Elle peut dégrader la qualité des résultats obtenus.
Il faut trouver le juste équilibre entre richesse d’information et rapidité. Des techniques de réduction de dimension existent pour soulager les index. C’est un travail d’orfèvre pour les ingénieurs de données. L’optimisation des vecteurs permet de conserver une précision chirurgicale sans exploser les coûts de stockage.
- Augmentation de la latence de calcul
- Besoin accru en mémoire vive (RAM)
- Dilution de la distance sémantique
Architecture RAG pour la performance des LLM
Au-delà du simple stockage, ces bases transforment la manière dont les modèles de langage interagissent avec le monde réel. C’est ici qu’entre en scène le RAG, le chaînon manquant vers une IA fiable.
Intégration de connaissances externes sans réentraînement coûteux
Le RAG permet d’injecter des faits frais dans la fenêtre de contexte du modèle. Plus besoin de dépenser des fortunes en réentraînement. L’IA consulte la base vectorielle comme une encyclopédie.
Cette architecture réduit les hallucinations, garantit un ancrage factuel strict, permet de citer des sources vérifiables et évite les coûts prohibitifs de mise à jour des modèles.
Cette méthode réduit drastiquement les hallucinations en forçant le modèle à citer ses sources. La fiabilité des réponses augmente immédiatement pour l’utilisateur final. C’est une sécurité indispensable en entreprise.
Vous pouvez par exemple connecter l’IA à votre CRM pour booster vos ventes. C’est une application concrète de Comprendre les bases de données vectorielles pour l’IA générative.
Importance du découpage sémantique ou chunking des données
Le chunking consiste à découper vos documents en morceaux digestes pour l’index. Un segment trop long dilue le sens. Un segment trop court perd le contexte nécessaire.
La taille idéale dépend de la complexité de vos textes sources. Il faut tester plusieurs stratégies de recouvrement pour assurer la continuité du sens. La pertinence de la réponse finale en dépend. Le découpage sémantique est souvent l’étape la plus sous-estimée du pipeline IA.
Un mauvais chunking rendra la meilleure base vectorielle du monde totalement inopérante pour un système RAG performant.
3 critères pour choisir et maintenir vos index
Pour finir, la mise en production d’un tel système exige une vigilance constante sur des points clés. Choisir son moteur est une chose, le faire vivre en est une autre.
Arbitrage entre vitesse de recherche et exactitude des résultats
Vous devez choisir entre une réponse instantanée et une précision absolue. En e-commerce, la vitesse prime. Pour le diagnostic médical, l’exactitude est non négociable. Définissez vos priorités.
La dimensionnalité de vos vecteurs impacte directement ce ratio critique. Un modèle d’embedding léger favorise la fluidité. Un modèle lourd privilégie la finesse du détail sémantique.
Combinez la recherche sémantique avec le filtrage de métadonnées, comme trouver une « histoire touchante » à moins de 20$, pour accroître la précision et la pertinence business.
Pour approfondir la stratégie, consultez : impact de la réglementation IA sur votre développement logiciel.
Stratégies de mise à jour dynamique et gouvernance sécurisée
Vos index doivent vivre sans interrompre votre service client. Utilisez des techniques de mise à jour à chaud. La fraîcheur des données garantit la pertinence de vos conseils IA.
La sécurité des vecteurs est cruciale car ils contiennent des informations sensibles. Chiffrez vos données au repos et contrôlez strictement les accès aux index. La gouvernance ne doit jamais être négligée. La protection des données est le pilier de la confiance utilisateur dans vos outils.
Consultez ce guide pour sécuriser votre application SaaS avec Next.js pour les bonnes pratiques.
Évaluation de la qualité via les métriques de rappel
Surveillez le rappel pour savoir si vous manquez des documents importants. La précision mesure la justesse des premiers résultats affichés. Ces indicateurs pilotent vos optimisations futures.
Si les scores stagnent, changez de modèle d’embedding ou affinez votre chunking. C’est un cycle d’amélioration continue indispensable. Ne laissez jamais vos index vieillir sans surveillance.
- Recall@K
- Mean Reciprocal Rank
- Latence P99
- Taux de compression
Maîtriser une base de données vectorielle c’est quoi concrètement ? C’est transformer vos données non structurées en embeddings mathématiques pour garantir une recherche sémantique ultra-rapide via des index HNSW ou IVF. Intégrez dès maintenant cette architecture RAG pour éliminer les hallucinations de vos LLM et propulser votre performance technique vers l’excellence opérationnelle.
FAQ
Qu’est-ce qu’une base de données vectorielle et quel est son rôle pour l’IA ?
Une base de données vectorielle est un système spécialisé conçu pour stocker, indexer et interroger des embeddings. Ces derniers sont des représentations numériques de données non structurées, comme du texte, des images ou du son, converties en tableaux de nombres flottants. Contrairement aux systèmes classiques, elle capture la signification sémantique des informations pour permettre aux modèles de machine learning de les traiter efficacement.
Son rôle principal est de situer chaque donnée dans un espace multidimensionnel où les éléments similaires sont mathématiquement rapprochés. Elle constitue le socle indispensable des applications modernes, permettant à l’intelligence artificielle de comprendre les relations contextuelles complexes plutôt que de simples correspondances de caractères.
En quoi la recherche vectorielle diffère-t-elle des requêtes SQL traditionnelles ?
La distinction majeure réside dans la méthode d’interrogation : là où le SQL repose sur des valeurs exactes et des mots-clés rigides, la base vectorielle utilise la recherche par similarité. Si vous effectuez une requête dans une base relationnelle, vous risquez de manquer des résultats pertinents faute de correspondance syntaxique parfaite. À l’inverse, le système vectoriel identifie l’intention réelle en trouvant les vecteurs les plus proches dans l’espace sémantique.
Cette approche offre une flexibilité totale pour traiter les formats multimédias et les nuances du langage humain. Vous passez d’une structure en tables et colonnes figées à une manipulation mathématique de concepts, ce qui est crucial pour découvrir des modèles cachés et générer des prédictions fiables sans dépendre de règles explicites préétablies.
Quelles sont les métriques utilisées pour mesurer la similarité entre les données ?
Pour déterminer la proximité entre deux vecteurs, les systèmes s’appuient sur des outils géométriques de haute précision. La distance euclidienne mesure l’écart direct entre deux points dans l’espace, tandis que la similarité cosinus analyse l’angle formé entre les vecteurs pour évaluer leur orientation sémantique. Le produit scalaire est également employé pour classer les résultats par ordre de pertinence décroissante.
Le choix de la métrique est déterminant pour la précision de vos résultats. Ces calculs permettent à l’IA de quantifier mathématiquement la ressemblance entre une requête utilisateur et les documents stockés, garantissant que les informations restituées sont les plus proches possible du besoin exprimé, même sans partage de mots-clés communs.
Comment les algorithmes HNSW et IVF optimisent-ils la vitesse de recherche ?
L’algorithme HNSW (Hierarchical Navigable Small World) crée une structure de graphe multicouche permettant de naviguer rapidement vers les zones d’intérêt. Il offre une latence minimale et une excellente précision, bien qu’il soit exigeant en mémoire vive. C’est la solution de choix lorsque vous privilégiez la performance brute et la finesse de recherche sur des serveurs dotés d’une RAM conséquente.
De son côté, IVF (Inverted File) fragmente l’espace vectoriel en clusters pour limiter le périmètre d’exploration. En combinant IVF avec la quantification de produit (PQ), vous réduisez l’empreinte mémoire, permettant de traiter des milliards de vecteurs sur des infrastructures plus modestes. Ces stratégies d’indexation avancées sont vitales pour maintenir une célérité de traitement optimale face à des volumes de données massifs.
Pourquoi l’architecture RAG est-elle essentielle pour vos projets d’IA générative ?
L’architecture RAG (Génération Augmentée par Récupération) utilise la base vectorielle comme une encyclopédie externe pour enrichir les grands modèles de langage (LLM). Elle vous permet d’injecter des connaissances fraîches et spécifiques à votre métier sans passer par un réentraînement coûteux. Le modèle consulte les vecteurs pertinents pour formuler ses réponses, ce qui garantit une fiabilité accrue et une mise à jour dynamique de ses savoirs.
Cette méthode réduit drastiquement les risques d’hallucinations en forçant l’IA à s’appuyer sur des sources vérifiables stockées dans votre index. En couplant vos données propriétaires à la puissance de calcul des LLM, vous créez des outils d’aide à la décision sécurisés, performants et parfaitement alignés avec les réalités opérationnelles de votre entreprise.
Qu’est-ce que le chunking et pourquoi influence-t-il la qualité des résultats ?
Le chunking, ou découpage sémantique, consiste à segmenter vos documents en morceaux digestes avant leur vectorisation. Si un segment est trop long, le sens global se dilue et la précision chute ; s’il est trop court, l’IA perd le contexte nécessaire à une compréhension fine. Trouver le juste équilibre est une étape critique pour assurer la continuité sémantique au sein de votre base.
La pertinence de la réponse finale dépend directement de la qualité de ce découpage. Un chunking optimisé permet d’extraire uniquement les informations les plus saillantes lors d’une requête, évitant ainsi de polluer la fenêtre de contexte du modèle avec des données superflues. C’est un levier de performance souvent sous-estimé, mais pourtant pilier de toute stratégie RAG efficace.