
L’intégration des modèles de langage dans les infrastructures critiques multiplie les vecteurs d’attaque, transformant chaque pipeline MLOps en une cible potentielle. Cette extension de la surface d’attaque expose vos systèmes à des risques d’exfiltration de données et de compromission sémantique sans précédent. Un audit sécurité application llm rigoureux devient alors le seul rempart contre ces menaces émergentes.
Je vais vous aider à cartographier vos vulnérabilités et à durcir vos protocoles pour garantir l’intégrité de votre écosystème IA. On décortique ensemble les points de contrôle indispensables pour sécuriser vos déploiements.
- Audit de sécurité LLM : cartographie et risques prioritaires
- Évaluation de la résilience aux injections de prompts
- Protection des bases vectorielles et mécanismes RAG
- Gouvernance et monitoring du cycle de vie IA
Audit de sécurité LLM : cartographie et risques prioritaires
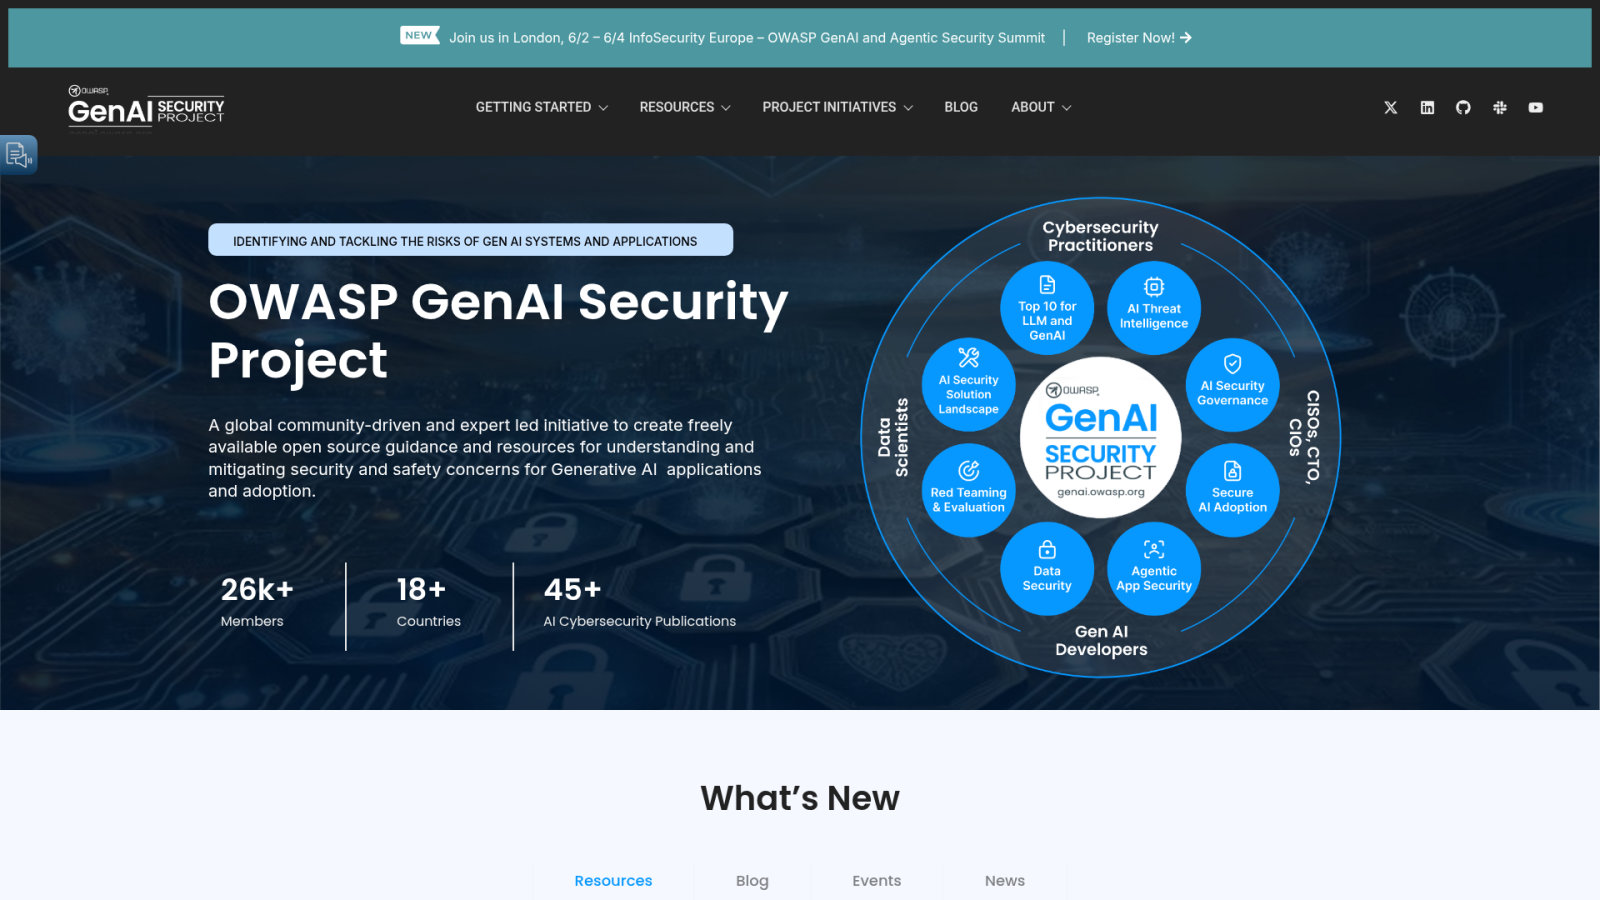
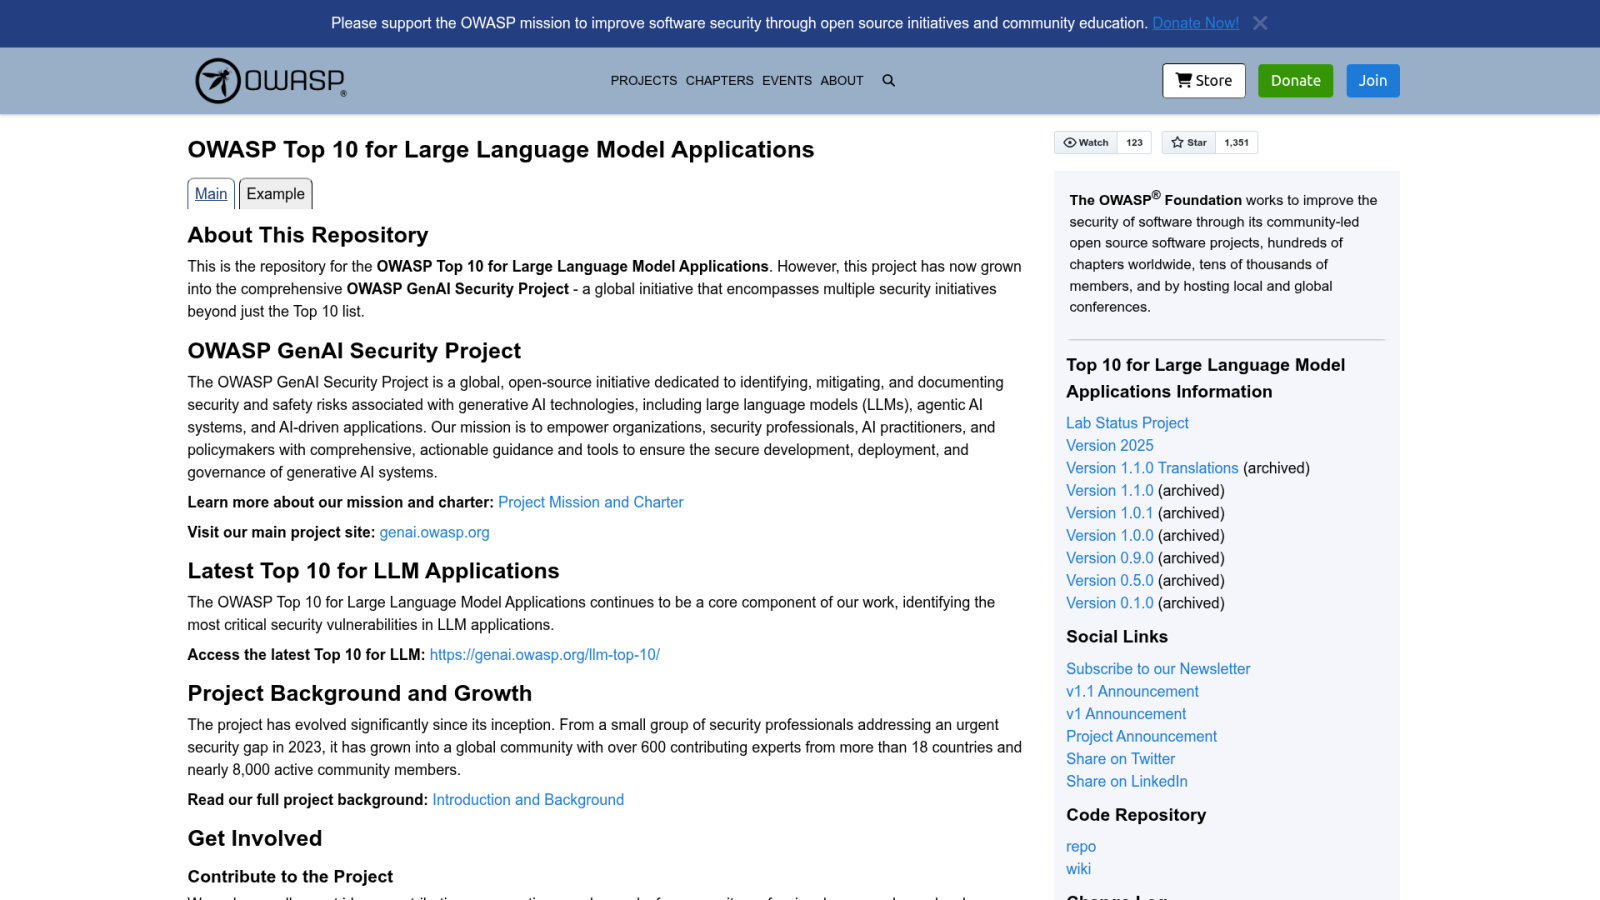
L’audit cible les injections de prompts, l’exfiltration via RAG et les failles MLOps. La sécurisation repose sur le filtrage des entrées, le Zero Trust des plugins et une cartographie rigoureuse des flux techniques afin d’établir un inventaire précis.
Dresser l’inventaire de la surface d’attaque technique
Vous devez impérativement recenser les composants du pipeline MLOps. Identifiez les connecteurs tiers et les orchestrateurs utilisés. C’est la base indispensable de votre visibilité technique globale.
Identifiez ensuite les flux de données entre l’utilisateur et le modèle. Cartographiez les points d’entrée API disponibles. Définissez précisément le périmètre d’exposition des interfaces pour limiter les surprises lors des tests d’intrusion.
Analysez enfin les dépendances logicielles critiques du système. Vérifiez scrupuleusement les accès aux bases vectorielles. La surface d’attaque englobe aussi vos scripts de prétraitement pour une sécurité des données optimale.
Il est impératif de séparer les vulnérabilités logicielles classiques touchant l’infrastructure des failles neuronales spécifiques qui ciblent directement la logique sémantique du modèle.
Hiérarchiser les menaces sémantiques et techniques
Distinguez les vulnérabilités logicielles classiques des failles neuronales spécifiques. Les premières touchent l’infrastructure réseau. Les secondes ciblent la logique même du modèle de langage.
Analysez les risques d’exfiltration de données sensibles via le RAG. Évaluez la probabilité des hallucinations pouvant induire vos utilisateurs en erreur ou compromettre l’intégrité des réponses.
Les modèles pré-entraînés peuvent contenir des backdoors. Auditez systématiquement le pipeline MLOps et vérifiez la provenance des poids avant tout déploiement en production.
Évaluez l’impact d’une compromission de la chaîne logistique IA. Les poids des modèles peuvent cacher des menaces dormantes. Voici les vecteurs prioritaires à surveiller :
- Injections de prompts directes
- Exfiltration via canaux indirects
- Empoisonnement des données
- Déni de service sémantique
Évaluation de la résilience aux injections de prompts
Une fois la surface d’attaque identifiée, vous devez éprouver la robustesse du modèle face aux manipulations textuelles malveillantes.
Simuler des scénarios de jailbreak et d’injections
Je teste vos techniques d’obfuscation et vos manipulations multilingues. J’utilise des encodages variés pour contourner vos filtres. Je simule des attaques adversariales complexes. Mon objectif est de forcer le modèle à ignorer ses directives de sécurité initiales.
J’éprouve la résistance aux instructions malveillantes dissimulées dans des documents. Ces injections indirectes sont particulièrement sournoises. Elles exploitent la confiance accordée aux sources externes pour sécuriser vos applications llm : les points d’audit critiques.
Les injections indirectes sont dissimulées dans des documents légitimes et exploitent la confiance envers les sources externes pour contourner les filtres.
Je mesure la persistance du contexte après une tentative d’intrusion. Le modèle doit rester stable malgré les sollicitations répétées.
La limite de protection contre les injections réside souvent dans l’équilibre entre utilité et sécurité stricte.
Valider l’étanchéité des filtres et contrôles de sortie
Je vérifie l’assainissement des réponses avant l’affichage final à l’utilisateur. Aucun contenu sensible ne doit fuiter. J’utilise des expressions régulières et des modèles de classification pour garantir l’intégrité.
Je teste vos classificateurs de toxicité et de fuite d’informations. Ces outils agissent comme une dernière ligne de défense. Ils doivent être calibrés avec précision pour éviter les faux positifs.
J’audite les mécanismes de repli en cas de détection d’anomalie. Le système doit basculer vers une réponse sécurisée prédéfinie. J’évite les messages d’erreur trop verbeux pour limiter l’exposition.
Je recommande de consulter mon guide technique sur Mistral AI. Ce document complète votre stratégie de défense.
Protection des bases vectorielles et mécanismes RAG
Au-delà du prompt, la sécurité repose sur l’intégrité des données récupérées dynamiquement par le système.
Appliquer le Zero Trust aux agents et plugins
Vous devez restreindre les privilèges d’accès aux outils de recherche documentaire. Chaque agent ne doit accéder qu’au strict nécessaire. Appliquez le principe du moindre privilège systématiquement. Cela limite les dégâts en cas de compromission d’un composant.
Isolez les index vectoriels par segment d’utilisateurs. Évitez la pollution des résultats entre différents contextes métiers. La segmentation est votre meilleure alliée contre l’exfiltration.
Contrôlez les autorisations dynamiques lors de l’exécution des tâches. Vérifiez chaque appel API en temps réel.
Sécuriser vos applications llm : les points d’audit critiques implique de bien comprendre le fonctionnement RAG pour protéger vos flux.
Masquer les données sensibles par anonymisation
Déployez des stratégies de masquage dynamique dans les requêtes envoyées au modèle. Remplacez les noms et chiffres par des jetons anonymes. Préservez la confidentialité sans dégrader la performance.
Auditez les processus de désidentification des données d’entraînement. Les vecteurs ne doivent pas permettre de reconstruire des informations personnelles. C’est un défi technique majeur pour la conformité.
Garantissez la conformité RGPD malgré l’opacité inhérente aux modèles neuronaux. Documentez chaque étape du traitement des données. La transparence reste une exigence réglementaire incontournable.
| Technique | Avantage | Risque résiduel |
|---|---|---|
| Anonymisation | Sortie définitive du champ RGPD. | Perte potentielle de l’utilité sémantique. |
| Pseudonymisation | Conservation de la réversibilité locale. | Ré-identification possible via la clé. |
| Chiffrement homomorphe | Calcul sur données chiffrées. | Consommation de ressources très élevée. |
| Masquage différentiel | Protection statistique robuste. | Complexité de mise en œuvre technique. |
Gouvernance et monitoring du cycle de vie IA
La sécurité n’est pas un état figé mais un processus continu intégré à chaque étape du développement.
Intégrer la sécurité dans les pipelines DevSecOps
Automatiser les tests adversariaux lors du versionnage des modèles. Intégrer des scans de vulnérabilités dans vos pipelines CI/CD. Chaque mise à jour doit subir une validation stricte. Ne laissez aucune faille s’introduire en production par négligence.
Gérer les secrets et clés API dans les environnements de développement. Utiliser des coffres-forts numériques robustes. Ne jamais coder en dur les identifiants dans les scripts d’entraînement.
Sensibiliser les équipes aux risques de l’IA fantôme. Le Shadow AI menace l’intégrité de votre infrastructure globale.
Anticiper l’avenir de l’IA dans le développement logiciel permet de mieux sécuriser vos applications llm : les points d’audit critiques dès maintenant.
Détecter les anomalies par analyse comportementale
Surveiller les requêtes suspectes en temps réel via la télémétrie avancée. Détecter les patterns d’attaque inhabituels. Réagir promptement pour bloquer les tentatives d’exfiltration massives de données.
Définir le rôle de la validation humaine dans les processus automatisés. L’homme doit rester dans la boucle pour les décisions critiques. C’est un garde-fou essentiel contre l’autonomie excessive.
Prévenir l’empoisonnement des données par un audit continu des sources. Vérifier l’intégrité des datasets au fil du temps. Une donnée corrompue peut ruiner des mois de travail.
Le monitoring comportemental est la clé pour identifier les menaces inconnues en temps réel.
Maîtriser l’audit sécurité application llm exige une cartographie rigoureuse, une résilience face aux injections et un cloisonnement Zero Trust des données. Sécurisez dès maintenant vos pipelines MLOps pour transformer ces vulnérabilités en actifs stratégiques. Un déploiement robuste garantit la pérennité de votre innovation technologique.
FAQ
Comment puis-je réaliser un audit de sécurité efficace pour mes applications LLM ?
Pour réaliser un audit rigoureux, vous devez adopter une approche multicouche qui dépasse les tests d’intrusion classiques. La première étape consiste à cartographier précisément votre surface d’attaque technique : recensez les composants de votre pipeline MLOps, les flux de données entre les utilisateurs et le modèle, ainsi que les connecteurs tiers (ERP, CRM, API). Cette visibilité est le socle indispensable pour identifier les points d’entrée vulnérables.
L’audit doit ensuite se structurer autour de trois piliers : l’évaluation de la résilience du modèle face aux manipulations sémantiques, l’analyse de la sécurité des intégrations logicielles et, enfin, l’examen de la gouvernance du cycle de vie des données. Je préconise une approche itérative, intégrant des tests automatisés dans vos pipelines CI/CD pour transformer cet audit en un processus de contrôle continu.
Quels sont les risques majeurs liés aux injections de prompts pour mon entreprise ?
Les injections de prompts représentent une menace critique car elles exploitent l’incapacité du modèle à distinguer les instructions système des entrées utilisateur. Une attaque réussie peut entraîner la divulgation d’informations sensibles, telles que des données clients ou des secrets commerciaux, et permettre l’exécution de commandes arbitraires sur vos systèmes connectés. C’est un vecteur direct de compromission de l’intégrité de vos processus décisionnels.
On distingue les injections directes, où l’utilisateur malveillant tente de « jailbreaker » le modèle, des injections indirectes, plus sournoises, où les instructions sont dissimulées dans des documents ou des pages web consultés par l’IA. Pour vous prémunir, vous devez impérativement valider et filtrer chaque entrée et sortie, tout en appliquant le principe du moindre privilège à vos agents conversationnels.
Comment sécuriser mes bases vectorielles dans une architecture RAG ?
La sécurisation de vos bases vectorielles repose sur l’application stricte du paradigme Zero Trust : ne jamais faire confiance, toujours vérifier. Vous devez mettre en place un contrôle d’accès granulaire en utilisant des métadonnées pour restreindre la consultation des vecteurs aux seuls utilisateurs autorisés. La segmentation des index par contexte métier est également une stratégie efficace pour prévenir l’exfiltration de données entre différents services.
Je vous conseille également de déployer des techniques de masquage dynamique et d’anonymisation avant l’ingestion des données. En chiffrant les informations au repos et en transit, et en auditant continuellement les requêtes de recherche vectorielle, vous garantissez la confidentialité de votre « mémoire organisationnelle » face aux tentatives de détournement.
Quels points de contrôle dois-je privilégier pour le monitoring de mon IA en production ?
Le monitoring doit se concentrer sur la détection des anomalies comportementales en temps réel. Vous devez surveiller la télémétrie pour identifier des patterns de requêtes suspects, signes potentiels d’une attaque par déni de service sémantique ou d’une tentative d’extraction massive. La validation humaine reste un garde-fou essentiel pour les décisions critiques afin de pallier toute dérive du modèle.
Enfin, l’audit continu de la conformité et de l’intégrité de vos jeux de données est vital. Vérifiez régulièrement que vos sources n’ont pas été corrompues (empoisonnement de données) et que vos filtres de sortie bloquent efficacement toute fuite d’information ou contenu toxique. La sécurité de votre IA n’est pas un état figé, mais une vigilance opérationnelle de chaque instant.
.wwc { –wwc-primary: #3b82f6; }