
Le réentraînement complet d’un modèle de langage coûte une fortune en ressources de calcul et fige vos connaissances à une date passée. Pour rester compétitif, vous devez impérativement comprendre rag ia afin de transformer vos actifs documentaires en une source de vérité dynamique et exploitable en temps réel.
Les chatbots classiques échouent souvent car ils inventent des faits lorsqu’ils manquent de contexte, ce qui nuit à votre crédibilité professionnelle. Je vais vous aider à maîtriser cette architecture qui connecte l’IA à vos bases de données vectorielles pour garantir des réponses précises, citables et sécurisées.
- Comprendre le fonctionnement du RAG pour l’IA en entreprise
- Mécanismes de récupération et traitement des données vectorielles
- Avantages compétitifs liés à la précision et aux coûts
- Cas d’usage professionnels et futures évolutions technologiques
Comprendre le fonctionnement du RAG pour l’IA en entreprise
Le RAG (Retrieval-Augmented Generation) fiabilise l’IA en connectant les LLM à des bases de données vectorielles privées. Cette architecture réduit les hallucinations en imposant une citabilité des sources, transformant radicalement le support client.
Technique connectant un LLM à des bases de connaissances externes fiables pour optimiser la précision des réponses produites.
Distinction entre LLM natif et architecture RAG
Un LLM classique est figé dans le temps. Ses connaissances s’arrêtent à sa date d’entraînement. C’est une limite majeure pour vos besoins.
L’architecture RAG change la donne. Elle ajoute un cerveau externe au modèle. Le système interroge vos documents avant de répondre. C’est une extension dynamique de la mémoire de l’IA.
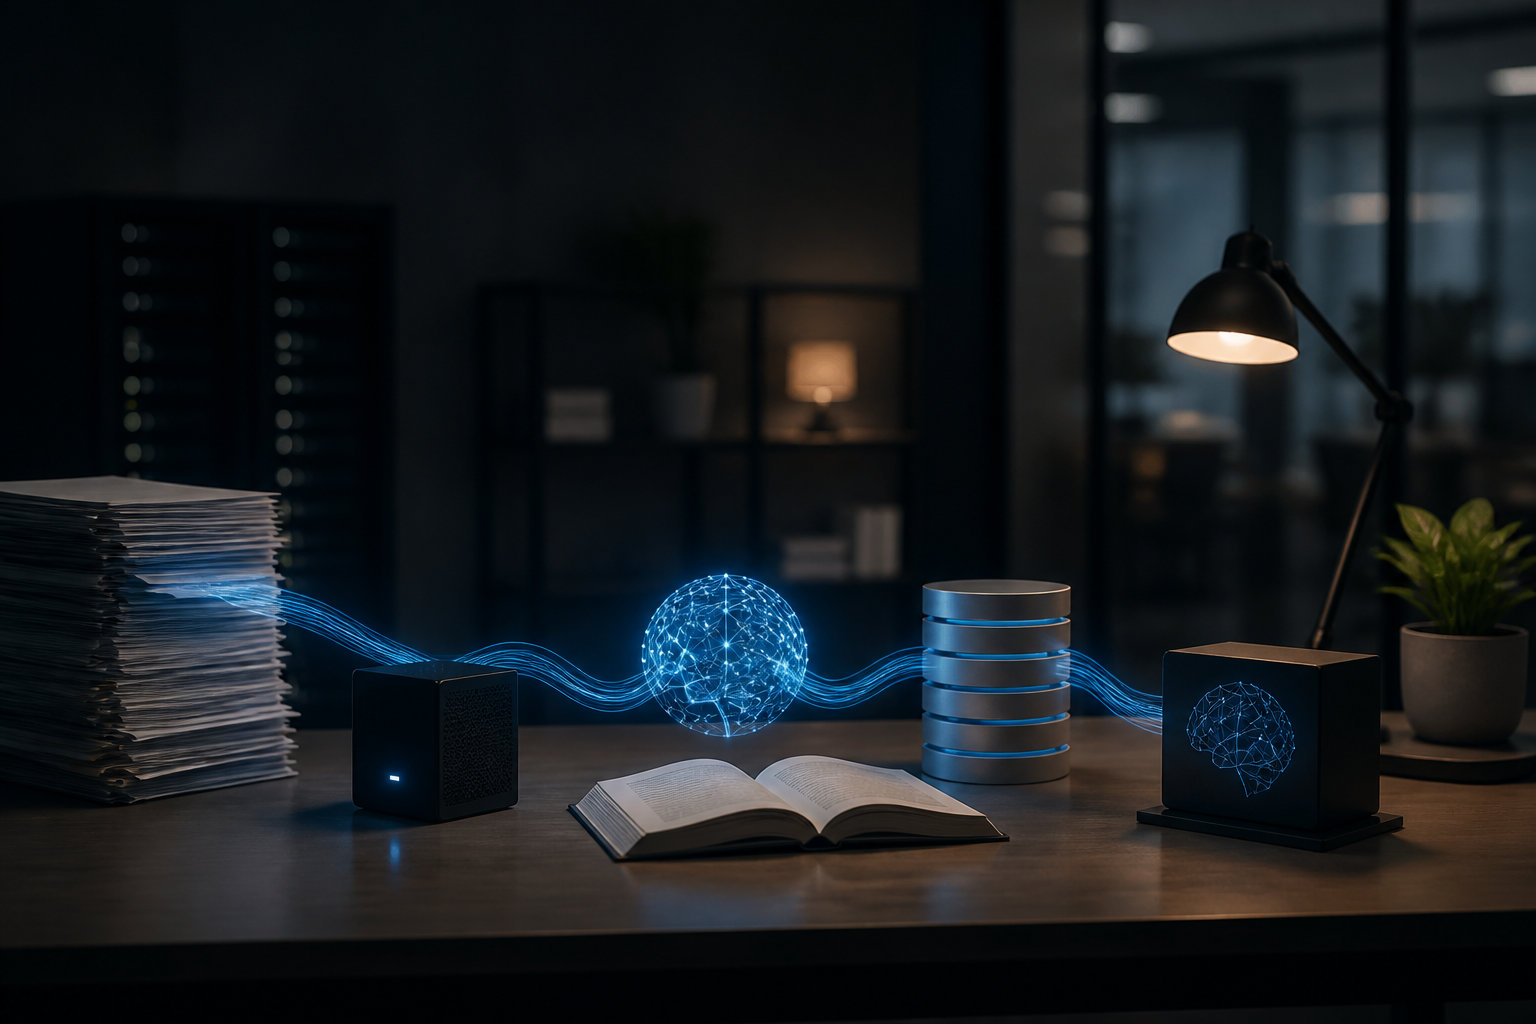
Cette approche hybride garantit une pertinence accrue. Je vous conseille d’analyser l’ impact de l’IA sur la stratégie SEO pour anticiper ces mutations. Comprendre le fonctionnement du RAG pour l’entreprise devient un levier de performance concret.
Les LLM natifs inventent parfois des faits (hallucinations), ce qui représente un danger réel pour vos applications métiers.
Fiabilité accrue face aux limites des chatbots traditionnels
Les chatbots classiques inventent souvent des faits. On appelle cela des hallucinations. C’est un risque inacceptable pour votre entreprise. Le RAG limite drastiquement ces erreurs factuelles.
Le RAG ne se contente pas de prédire le mot suivant, il va chercher la vérité dans vos propres fichiers avant de s’exprimer avec assurance.
Vos données restent à jour en permanence. Pas besoin de relancer un entraînement complexe. La réactivité du système devient votre meilleur atout stratégique au quotidien.
Mécanismes de récupération et traitement des données vectorielles
Pour comprendre cette efficacité, il faut soulever le capot et observer comment vos documents deviennent exploitables par la machine.
Rôle des embeddings et du stockage vectoriel
Vos textes sont convertis en listes de nombres. Ce sont les embeddings. Ils capturent le sens profond de vos phrases. La machine comprend enfin les concepts.
Ces vecteurs sont stockés dans des bases spécialisées. Elles permettent des recherches ultra-rapides. Le système compare la question de l’utilisateur avec les données disponibles en un éclair.
La similarité sémantique guide alors la sélection. C’est la clé pour intégrer un LLM dans une application métier avec succès.
Étapes de l’augmentation de la requête utilisateur
Quand vous posez une question, le système l’enrichit. Il pioche dans le stock vectoriel les extraits les plus pertinents. Votre demande devient une requête ultra-documentée.
Le LLM reçoit alors la question et le contexte. Il n’a plus besoin de deviner. Il rédige sa réponse en s’appuyant sur les éléments fournis.
Ce flux garantit une précision chirurgicale. L’information circule de la source brute vers une réponse structurée et fiable pour vos équipes.
- Préparation : Collecte et conversion en embeddings.
- Récupération : Recherche de similarité vectorielle.
- Génération : Réponse augmentée par le contexte.
Intégration de documents variés comme les PDF ou emails
Le RAG accepte presque tout. PDF, emails, ou tableurs sont les bienvenus. Le système brise les silos d’information. C’est une force pour votre gestion documentaire.
- Extraction de texte brut
- Découpage en segments (chunking)
- Génération des vecteurs de sens
- Indexation finale
Maîtriser ces flux assure la sécurité des données lors de l’intégration LLM. C’est un impératif technique majeur.
Avantages compétitifs liés à la précision et aux coûts
Au-delà de la technique pure, cette architecture offre des bénéfices concrets sur votre rentabilité et la sécurité de vos actifs numériques.
Suppression des hallucinations par la citabilité des sources
La transparence est le pilier du RAG. Chaque réponse peut citer ses sources exactes. L’utilisateur vérifie l’information en un clic. Cela renforce immédiatement la confiance interne.
Une IA qui cite ses sources n’est plus une boîte noire, mais un collaborateur transparent et auditable par tous.
La qualité de votre information produite grimpe en flèche. Vos collaborateurs ne doutent plus des résultats fournis par l’outil.
Comparaison économique avec le réentraînement des modèles
Le fine-tuning coûte une fortune en calcul. Le RAG est bien plus sobre. Vous mettez à jour vos données sans toucher au modèle de base. C’est un gain financier énorme.
| Critère | Fine-tuning | RAG |
|---|---|---|
| Coût | Élevé (GPU/TPU) | Faible (Infrastructure) |
| Fréquence de mise à jour | Lente (Cycles longs) | Instantanée (Temps réel) |
| Précision factuelle | Variable (Risque élevé) | Élevée (Ancrage réel) |
| Empreinte carbone | Élevée (Entraînement) | Faible (Récupération) |
Je constate que maîtriser le coût de développement global passe par ces choix d’architecture économes. Le RAG s’impose ici.
Maîtrise de la sécurité et confidentialité des données
Vos données sensibles ne sortent pas de votre infrastructure. Le RAG respecte vos droits d’accès existants. Un employé ne verra que ce qu’il est autorisé à lire.
La conformité RGPD devient plus simple à gérer. Vous contrôlez la source de vérité en temps réel. C’est une garantie indispensable pour votre direction technique.
La protection de vos secrets industriels est ainsi assurée. L’IA travaille pour vous, en toute sécurité.
Cas d’usage professionnels et futures évolutions technologiques
Mais concrètement, comment vos équipes vont-elles utiliser cet outil au quotidien et vers quoi nous dirigeons-nous ?
Amélioration du support client et de l’aide à la décision
Votre support client gagne en efficacité. Les agents trouvent les réponses techniques en quelques secondes. La satisfaction de vos clients progresse mécaniquement grâce à cette rapidité.
- Analyse de contrats juridiques
- Synthèse de rapports financiers
- Aide au diagnostic technique
- Onboarding des nouveaux salariés
Le gain de temps est massif pour vos experts. Une formation IA équipes techniques devient alors le levier principal pour exploiter pleinement ces outils.
Transition vers le GraphRAG et les données multimodales
L’avenir s’appelle GraphRAG. Il utilise des graphes de connaissances pour lier les concepts entre eux. Le raisonnement de l’IA devient alors beaucoup plus complexe et structuré.
GraphRAG utilise des graphes de connaissances pour lier les concepts, permettant à l’IA d’effectuer un raisonnement plus complexe et structuré que la recherche vectorielle standard.
La multimodalité arrive aussi. Le système pourra bientôt analyser vos graphiques et vos images techniques. L’interaction avec vos documents ne connaîtra plus aucune limite de format.
Les agents autonomes basés sur le RAG approchent. Anticiper l’ avenir IA développement logiciel 2026 permet de comprendre le fonctionnement du RAG pour l’entreprise en profondeur.
Préparez vos équipes dès maintenant. Cette technologie est le socle de votre future compétitivité numérique. Ne laissez pas passer ce train.
En maîtrisant l’architecture RAG, vous transformez vos LLM en experts fiables, capables de citer leurs sources et d’éliminer les hallucinations. Pour comprendre le RAG en IA, retenez que cette technologie sécurise vos données tout en optimisant vos coûts opérationnels. Adoptez dès maintenant cette stratégie pour garantir la pertinence de vos décisions futures.
FAQ
Quelle est la différence concrète entre un LLM classique et une architecture RAG ?
Un LLM natif s’appuie exclusivement sur ses données d’entraînement initiales, ce qui rend ses connaissances statiques et sujettes à une date de coupure. Je constate que cela limite sa pertinence pour traiter des sujets d’actualité ou des données d’entreprise confidentielles.
L’architecture RAG (Retrieval-Augmented Generation) transforme l’IA en un expert capable de consulter une bibliothèque externe en temps réel. Elle connecte le modèle à vos propres documents, garantissant ainsi que les réponses sont basées sur des informations spécifiques, privées et parfaitement à jour.
Comment le système RAG parvient-il à éliminer les hallucinations de l’IA ?
Les hallucinations surviennent lorsqu’un modèle tente de combler une lacune de connaissances par une prédiction statistique erronée. Avec le RAG, j’impose au modèle un cadre strict : il doit puiser ses réponses dans les extraits de documents récupérés dans votre base vectorielle avant de s’exprimer.
Cette méthode permet également de citer les sources utilisées pour chaque réponse. L’utilisateur peut ainsi vérifier l’exactitude de l’information en un clic, ce qui instaure une transparence totale et une fiabilité indispensable pour vos processus métiers.
Est-il plus rentable d’utiliser le RAG que de réentraîner un modèle d’IA ?
Absolument. Le réentraînement, ou fine-tuning, est un processus extrêmement coûteux en ressources de calcul et complexe à maintenir dès que vos données changent. Le RAG offre une sobriété économique majeure puisque vous ne modifiez pas le modèle de base.
Je privilégie cette approche car elle permet une mise à jour instantanée de vos connaissances. Il suffit d’ajouter ou de modifier un document dans votre base de données vectorielle pour que l’IA intègre l’information, sans dépenser un centime en calculs supplémentaires.
Comment le RAG garantit-il la sécurité de mes données confidentielles ?
Le RAG maintient une séparation hermétique entre le modèle de langage et vos connaissances externes. Vos fichiers sensibles, tels que les PDF, emails ou contrats, sont stockés dans votre infrastructure sécurisée et ne servent jamais à l’entraînement public du modèle.
En tant qu’expert, je souligne que ce mécanisme permet de gérer finement les droits d’accès. Le système ne récupère que les informations que l’utilisateur est autorisé à consulter, assurant ainsi une conformité stricte avec vos politiques de sécurité et le RGPD.
Quelles sont les étapes techniques pour transformer mes documents en données exploitables ?
Le processus débute par le chunking, où je découpe vos documents en segments digestes. Ces extraits sont ensuite convertis en embeddings, des représentations numériques capturant le sens sémantique, puis indexés dans une base de données spécialisée.
Lorsqu’une question est posée, le système effectue une recherche vectorielle pour identifier les segments les plus pertinents. Ces données sont injectées dans le prompt du LLM, lui fournissant le contexte nécessaire pour générer une réponse d’une précision chirurgicale.
.wwc { –wwc-primary: #3b82f6; }